Cuando se habla de inteligencia artificial y música, la conversación casi siempre gira en torno a un sistema que recibe una instrucción y entrega un resultado (una canción, un fragmento instrumental, una voz) sin que nadie intervenga entre la petición y la respuesta. Normalmente no se piensa en instrumentos basados en IA que el músico pueda tocar..
Pero a través de esta serie de artículos nos estamos centrando en otro uso de estos modelos: el de la IA que entra en un punto del proceso y deja el control en manos de quien hace la música.
En el primer artículo de la serie vimos que una herramienta acompaña o sustituye según cuánto control conserva quien la usa. En el siguiente, que un modelo puede aprender el timbre de un violín y que es lo bastante pequeño para funcionar en tiempo real.
Que una IA pueda funcionar en tiempo real permite algo muy interesante: poder tocar el modelo, potencialmente, igual que se toca un instrumento. Quien toca mueve un control, escucha al instante cómo cambia el sonido y decide con eso el siguiente movimiento. Y de hecho hay músicos que llevan años haciéndolo en directo.
En una actuación documentada en 2024, tres intérpretes, dos de ellos del colectivo mexicano RGGTRN, tocaban a la vez un mismo modelo de IA. En una improvisación a tres, cada uno controlaba una parte de sus parámetros, repartidos de antemano para no pisarse de la misma manera en la que se reparten las voces en un grupo.
¿Pero lo que estaban haciendo esas tres personas era tocar un instrumento o manejar una máquina que generaba sonido? Dicho de otra manera: ¿la IA los estaba acompañando o sustituyendo?
¿Qué define a un instrumento?
Para que el ciclo de mover, escuchar lo que devuelve la IA y corregir el gesto sea equivalente a tocar un instrumento tienen que darse cuatro condiciones.
La primera es que el sonido llegue a tiempo. Lo que significa “a tiempo” depende de lo que se toque, porque no es lo mismo una percusión que un sonido que evoluciona despacio. Si el sonido llega tarde, el músico tiene que tocar adelantándose a lo que todavía no ha oído.
La segunda es la estabilidad, que el instrumento no cambie de una sesión a otra. La relación entre gesto y sonido tiene que ser la misma hoy y mañana, porque si cambia, lo que el músico aprendió ayer deja de servirle.
La tercera es que quien toca esté dentro del sonido todo el tiempo, influyendo en él de forma continua, y no se limite a ponerlo en marcha y vigilar lo que hace.
La cuarta es que practicar sirva de algo. Nadie repite un gesto exactamente igual, ningún violinista toca dos veces la misma nota de la misma manera, así que dos gestos parecidos tienen que dar sonidos parecidos. Un instrumento puede ser estable y fallar en esto, si responde de forma tan sensible que un milímetro de diferencia en la mano da un sonido muy distinto, y entonces el músico no consigue volver al sonido que buscaba por mucho que repita.
Lo que se ve hoy en los congresos puede parecer todavía muy experimental, y lo es, pero también lo eran los primeros sintetizadores. El Moog modular se presentó en 1964 como un mueble lleno de módulos que se conectaban con cables, hizo falta Switched-On Bach, en 1968, para que el gran público lo oyera, y el Minimoog, en 1970, para que cupiera en un escenario. En esos años, la técnica para tocarlos la fueron inventando los propios músicos.
Las tres piezas de un instrumento basado en IA
En un instrumento basado en un modelo de IA intervienen hasta tres piezas.
Las dos primeras piezas forman el modelo de sonido: un codificador recibe el audio y lo resume en una lista corta de números que describe cómo suena en cada momento; un decodificador hace el camino contrario, convirtiendo esos números otra vez en sonido.
Esa lista intermedia, que en la jerga se llama representación latente, es lo que el músico acaba tocando. Así funciona RAVE, el modelo de síntesis en tiempo real del IRCAM (Institut de Recherche et Coordination Acoustique/Musique, el centro de investigación musical de París) que ya citamos en el primer artículo de la serie, y es el que tocaban los tres intérpretes que mencionamos al inicio del artículo.
La tercera pieza es el mapeo, la correspondencia que determina qué gesto del músico modifica cada uno de los valores de la representación latente y en qué medida. Que haga falta o no depende de cómo se toque el modelo de sonido, y hay dos maneras de hacerlo:
Con un instrumento. El músico canta o toca, el codificador convierte ese sonido en números y el decodificador los devuelve como sonido, pero con el timbre que aprendió el modelo. Si el modelo se entrenó con grabaciones de violín, lo que se canta sale sonando a violín. No se necesita la tercera pieza.
Sin sonido de entrada. Se prescinde del codificador y se recurre al mapeo. El músico mueve un mando, un lápiz sobre una tableta o la mano delante de una cámara, y el mapeo convierte esos movimientos en cambios en los números que recibe el decodificador.
Las dos maneras se pueden combinar, y así tocaban los tres intérpretes del principio. El codificador convertía en números, una y otra vez, un fragmento grabado de 25 segundos, y cada uno alteraba su parte de esos números antes de que llegaran al decodificador.
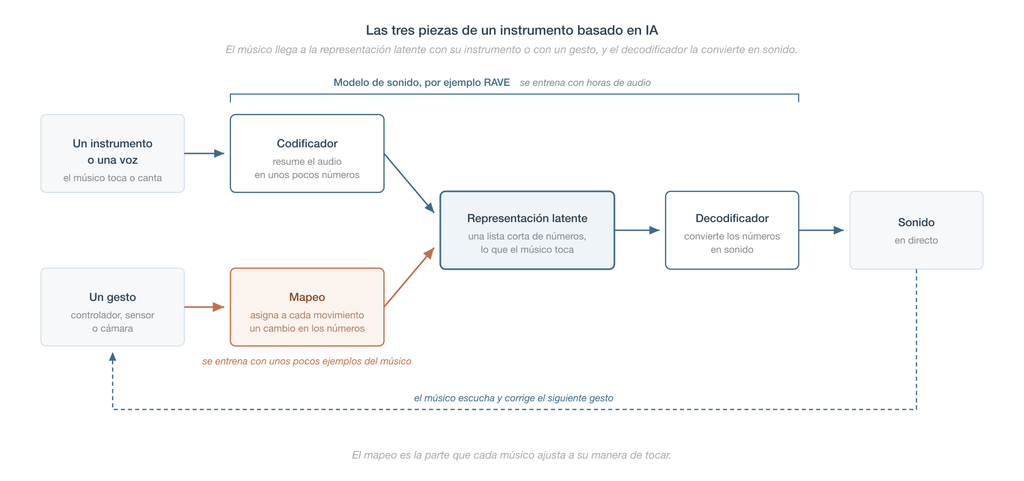
Separar las tres piezas nos permite aclarar a qué nos referimos cuando decimos que un músico “entrena una IA”, porque puede estar haciendo dos cosas muy distintas: entrenar el modelo de sonido requiere de horas de grabación y días de cálculo; entrenar el mapeo se hace con unos pocos ejemplos, y es el paso en el que el modelo se convierte en el instrumento de alguien en concreto.
El espacio latente como material
Cada combinación posible de los números de la representación latente corresponde a un sonido, y durante el entrenamiento quedan organizadas de forma que las combinaciones cercanas suenan de forma parecida.
El resultado es una especie de mapa de todos los sonidos que el modelo sabe hacer, y a ese mapa se le llama espacio latente. Tocar el modelo es moverse por él, y pasar despacio de un punto a otro produce una transición entre dos sonidos.
Ese mapa no tiene leyenda. En un sintetizador cada mando tiene un nombre (filtro, ataque, volumen) y hace siempre lo mismo, pero en un espacio latente los números no vienen etiquetados. En muchos modelos RAVE el primero de los números de la representación latente suele moverse con la intensidad del sonido (pero no está garantizado), y los demás mezclan altura, brillo y ataque. Un estudio de 2024 comparó modelos entrenados por separado de la misma manera y encontró que una misma dirección podía funcionar al revés de uno a otro, lo que en uno subía en el otro bajaba.
Parece un obstáculo para tocar, pero los instrumentos acústicos tampoco traen leyenda. Un saxofonista aprende de oído en qué punto se le rompe el sonido, y un violinista aprende cuánto arco pide cada cuerda sin que nadie le haya dado antes una tabla. Con un espacio latente pasa lo mismo, el músico encuentra a través de la exploración las zonas que le interesan y los recorridos que puede repetir.
Lo que sí impide tocar es que el mapa cambie. El teremín se toca sin tocarlo, moviendo las manos en el aire, pero aunque sea difícil de dominar es estable: la misma distancia de la mano da siempre la misma nota, y eso permitió que Clara Rockmore desarrollara con él una técnica de concierto. En un modelo de IA la relación entre gesto y sonido la aprende la red, y si se vuelve a entrenar puede cambiar.
La latencia, en profundidad
Que un modelo “funcione en tiempo real” puede querer decir tres cosas distintas.
La primera tiene que ver con la velocidad de cálculo, si el procesador produce el sonido más deprisa de lo que se reproduce. El RAVE original de 2021 generaba unas veinte veces más audio por segundo del necesario, y de ahí viene la cifra de “veinte veces más rápido que el tiempo real” con la que el IRCAM presenta RAVE.
La segunda tiene que ver con la latencia del propio modelo, lo que tiene que esperar o acumular antes de devolver el sonido. Es la cifra que importa para tocar, y en RAVE depende de cómo se haya entrenado. Sus autores midieron 653 milisegundos en una versión adaptada a posteriori para funcionar en directo, más de medio segundo, y 52 milisegundos en otra entrenada desde el principio para generar cada instante de sonido solo con lo que ya ha recibido, sin esperar al audio que todavía no ha llegado. En 2025, BRAVE, un diseño de investigación pensado expresamente para tocar, bajó de los 10 milisegundos.
Para que nos hagamos una idea, el sonido recorre en el aire algo más de un metro cada tres milisegundos. Tocar con 52 milisegundos de retardo es como tocar con el amplificador a unos dieciocho metros, y con 10 milisegundos de retardo es como tenerlo a tres metros y medio, que es lo habitual en un escenario. Algunos instrumentos tradicionales también responden con retardo. En una iglesia grande la consola del órgano puede quedar lejos de los tubos, y a esa distancia se suma lo que tarda el mecanismo en llevar la orden de la tecla al tubo, así que el organista aprende a tocar por delante de lo que oye.
Por último, la tercera tiene que ver con el retardo total entre el gesto del músico y lo que oye, que suma al modelo la tarjeta de sonido, el ordenador y la monitorización. No se deduce de las otras dos, hay que medirlo con el equipo y la configuración que se vayan a usar en el escenario.
Circula la idea de que por encima de 14 milisegundos no se puede tocar, sacada de un experimento de 2004 de Chafe y Gurevich, en Stanford. Ponía a dos personas a marcar un ritmo con palmas, oyéndose la una a la otra con retardo, como en una actuación a distancia por internet, y a partir de 14 milisegundos el 85% de las interpretaciones se ralentizaba. Para el retardo entre un músico y su propio instrumento no fija ningún límite.
Cómo se toca una IA: las interfaces y el gesto aprendido
Desde 2001, quienes diseñan instrumentos nuevos se reúnen cada año en NIME (New Interfaces for Musical Expression, la conferencia internacional sobre interfaces musicales), y en los últimos años han empezado a presentar allí instrumentos hechos con modelos como RAVE.
Un estudio publicado en 2025 observó de cerca cómo se aprende a tocar uno. Sus autores entrenaron un RAVE con unas dos horas de guitarra pulsada y lo conectaron a una tableta con lápiz, de forma que cada punto de la superficie correspondía a un punto del espacio latente, y analizaron cómo lo tocaban doce músicos en sesiones de hora y media. En ese tiempo ya aparecieron gestos propios, trazos rápidos, bucles, garabatos, puntos sueltos, y algunos cambiaron la manera de coger el lápiz (como una batuta para los movimientos amplios y cerca de la punta para los precisos). Como el modelo sonaba a guitarra, varios acabaron moviendo el lápiz como si rasguearan o pulsaran cuerdas.
La tableta convierte el mapa en una superficie que se recorre con la mano, sin que el músico tenga que manejar los números del modelo uno a uno. Es una de las maneras de tocar un espacio sin leyenda.
Otra es dejarlo tal como sale del entrenamiento y aprenderlo con el cuerpo, como en Stacco, un instrumento de imanes y sensores magnéticos cuyos campos se solapan igual que se mezclan los números del modelo.
La tercera es que el músico enseñe al sistema qué gesto quiere para cada sonido. Esta última viene del Wekinator, un programa que Rebecca Fiebrink y sus colegas presentaron en NIME en 2009 y que aprendía la relación entre gesto y sonido a partir de unos cuantos ejemplos del músico. En 2023, Fiebrink y Gabriel Vigliensoni aplicaron la idea a RAVE. El músico recorre el modelo, elige los sonidos que le interesan, los asocia a posiciones de su propio gesto, y con unas decenas de ejemplos el sistema aprende la correspondencia. Así el mapeo queda hecho a la medida de cada músico.
¿Qué herramientas siguen vivas?
A fecha de octubre de 2026, varias de las herramientas que se citan en los tutoriales de estos años están sin mantener. RAVE sigue disponible y su código ha tenido actividad este año. Para tocarlo en directo, la herramienta habitual es nn~, la extensión que lo lleva a Max y Pure Data, dos entornos de programación muy usados en la música electrónica en vivo, con una versión nueva que data de mayo de 2025. El plugin oficial de RAVE para programas de producción es de abril de 2024.
Quien quiera tocar estos modelos dentro de su programa de producción habitual tiene hoy una opción más sencilla: Neutone FX, un plugin gratuito para Mac y Windows que carga modelos de distintos tipos, RAVE entre ellos. Es un reproductor de modelos, y lo rápido que responda depende del modelo que se cargue. La misma empresa vende Morpho, una herramienta de pago para entrenar modelos con el audio del propio músico.
Para el mapeo, las herramientas vivas son FluCoMa, nacida en la Universidad de Huddersfield, y Data Knot, de Rodrigo Constanzo, pensada para tocar en directo, con versión de marzo de 2026. El Wekinator no se actualiza desde 2016.
Construirse un instrumento propio
Quien quiera tocar un modelo con su propio sonido tiene que empezar por grabarse. El tutorial del IRCAM pide al menos una hora de audio para entrenar RAVE, y las guías prácticas hablan de dos o tres horas para un instrumento con un repertorio variado. Y no basta con la duración. La guía de Morpho lo explica con un ejemplo: una hora en la que el instrumento recorra intensidades, alturas y articulaciones es preferible a tres horas de la misma nota repetida.
Estos modelos tampoco funcionan como un sampler, que siempre devuelve la nota que se toca. Morpho aprende cómo suena el instrumento, pero no trata la nota como algo que tenga que respetar. Si el músico toca un do sostenido y en las grabaciones de entrenamiento apenas había dos sostenidos, el resultado puede desviarse hacia la nota más cercana de las que sí aparecían, por ejemplo un re. Por eso la guía recomienda grabar en una sola tonalidad y, si hacen falta todas las notas, escalas cromáticas completas.
Entrenar lleva tiempo y requiere de un equipo adecuado. El IRCAM pide una tarjeta gráfica potente, calcula de una semana a casi un mes de entrenamiento y sugiere alquilar la máquina si no se tiene. Morpho se encarga de esa parte, se le sube el audio y se paga el entrenamiento, pero el modelo que sale, que es privado y del músico, solo funciona dentro de Morpho. Un RAVE entrenado por uno mismo, en cambio, se puede tocar con nn~, con el plugin oficial o con Neutone FX. Un instrumento que solo suena dentro de un programa dura vivo lo que dure ese programa. Después queda ajustar el mapeo y practicar con él, y eso lleva meses, como con cualquier instrumento.
El aspecto legal
En el artículo anterior la pregunta era de quién es el timbre que aprende un modelo. Aquí la pregunta es otra, más práctica. Si un músico toca un modelo y graba el sonido resultante, ¿con qué licencia puede publicar ese sonido en un disco?
El repositorio oficial de RAVE se publica con una licencia CC BY-NC (Creative Commons Reconocimiento-NoComercial). Esa licencia cubre lo que hay en el repositorio, así que no se puede dar por hecho que se aplique a cada sonido que salga del modelo, pero tampoco que permita un uso comercial por el hecho de poder descargarlo. Los modelos ya entrenados que ofrece el IRCAM indican con qué se entrenó cada uno (“ocho horas de darbuka”, por ejemplo) pero no dicen qué se puede hacer con lo que suena. Morpho, en cambio, sí lo deja por escrito. Autoriza el uso comercial del audio que produce, los modelos que entrena cada músico son privados y suyos, y advierte de que no se puede entrenar con grabaciones de otro artista sin permiso de quien tenga los derechos.
En realidad son cuatro preguntas que suelen confundirse: la licencia del modelo, la de las grabaciones con las que se entrenó, la del programa con el que se toca y lo que se puede hacer con una grabación concreta. Que una tenga respuesta no resuelve las otras tres.
También hay modelos hechos con consentimiento, y en ellos el intérprete aparece con nombre. El catálogo de Neutone incluye un modelo de saxofón soprano del Intelligent Instruments Lab de Reikiavik que identifica como material de entrenamiento las improvisaciones de la saxofonista Franziska Schroeder. El IRCAM y Neutone distribuyen el modelo de voz de Jaap Blonk, entrenado con sus propias interpretaciones. Morpho anunció en 2024 un programa de modelos de artista con reparto de ingresos por la venta de cada modelo, aunque sus condiciones no son públicas.
En las fuentes revisadas no aparece ningún conflicto documentado por un modelo tocable que reproduzca el timbre de un intérprete identificable, lo que no quiere decir que no vaya a haberlo.
¿Podemos hablar de virtuosismo?
De las cuatro condiciones que planteábamos al principio para considerar algo un instrumento, las tres primeras ya se cumplen en algunas configuraciones concretas de modelo, interfaz y mapeo.
Hay modelos que responden lo bastante rápido para tocar, mapeos estables que se pueden aprender y músicos que intervienen en el sonido todo el tiempo.
La cuarta condición, que practicar sirva de algo, es la que menos pruebas tiene. El estudio de la tableta de 2025 vio aparecer gestos propios en hora y media, y algún proyecto artístico ha trabajado con el mismo sistema durante mucho más tiempo, pero en lo publicado hasta ahora no hay ningún estudio que siga a un grupo de músicos durante meses con un mismo modelo y compruebe si, con la práctica, consiguen volver a los sonidos que buscan. Con el violín o con el sintetizador sí que hay generaciones de intérpretes que muestran hasta dónde llega la práctica.
Por ahora se puede hablar de músicos que están aprendiendo a tocar estos instrumentos. Para hablar de virtuosos hará falta tiempo y alguien que lo estudie.
La escena cercana y el hueco español
Todo esto puede parecer todavía cosa de laboratorio, y en buena parte lo es, pero el camino del laboratorio al escenario puede ser corto.
Al Moog le bastaron seis años para pasar de un mueble lleno de módulos a un instrumento que cabía en un escenario, y hoy un músico con un ordenador puede descargar gratis un plugin y tocar uno de estos modelos esa misma tarde. Para hacerse una idea de cómo suena, hay grabaciones de un concierto en el que se toca la flauta a través de un modelo entrenado con cantos de pájaros y de un concierto con el Living Looper, un sistema que convierte lo que toca el intérprete en bucles que siguen cambiando.
En España la investigación está, sobre todo en el Music Technology Group de la Universitat Pompeu Fabra, que ha presentado trabajos en las últimas ediciones de NIME. Uno de ellos acompañó a Raül Refree en el Palau Güell de Barcelona con un sistema que generaba en tiempo real secuencias para los órganos a partir de lo que él tocaba. Lo que no hemos encontrado son intérpretes españoles tocando estos modelos en concierto, ni talleres de RAVE o de nn~ entre 2023 y 2026, ni materiales para aprender en castellano. NIME tampoco se ha celebrado nunca en España. En 2023, cuando se celebró en Ciudad de México, hubo seis trabajos de instituciones hispanohablantes, frente a dos en 2024 y uno en 2025.
Si estos instrumentos llegan a los escenarios en pocos años, como llegaron los sintetizadores, la técnica para tocarlos la inventarán los músicos que tengan dónde aprenderla.
Fuentes
El modelo y la latencia
Caillon, A., Esling, P. (2021). RAVE: A variational autoencoder for fast and high-quality neural audio synthesis. arXiv:2111.05011. [Unas 985.000 muestras por segundo en el procesador de un portátil, unas veinte veces las necesarias para audio a 48 kHz.]
Caillon, A., Esling, P. (2022). Streamable Neural Audio Synthesis With Non-Causal Convolutions. DAFx 2022. arXiv:2204.07064. [Los 653 ms de un modelo adaptado al directo después de entrenarlo y los 52 ms de uno entrenado desde el principio para responder sin mirar hacia delante.]
Caspe, F., Shier, J., Sandler, M., Saitis, C., McPherson, A. (2025). Designing Neural Synthesizers for Low-Latency Interaction. Journal of the Audio Engineering Society, 73(5), 240-255. DOI:10.17743/jaes.2022.0204. [BRAVE, por debajo de 10 ms.]
Chafe, C., Gurevich, M. (2004). Network Time Delay and Ensemble Accuracy: Effects of Latency, Asymmetry. 117th AES Convention, San Francisco. ccrma.stanford.edu/~cc/vox/aesFinal.pdf [El experimento de las palmas. A partir de 14 ms de retardo, el 85 % de las interpretaciones se ralentizaba.]
Tocar un espacio latente
Shaheed, N., Wang, G. (2024). I Am Sitting in a (Latent) Room. NIME 2024, Utrecht. DOI:10.5281/zenodo.13904872. [La actuación de tres intérpretes, dos de ellos del colectivo RGGTRN, con un modelo RAVE entrenado a medida.]
Privato, N., Shepardson, V., Lepri, G., Magnusson, T. (2024). Stacco: Exploring the Embodied Perception of Latent Representations in Neural Synthesis. NIME 2024, Utrecht, pp. 424-431. DOI:10.5281/zenodo.13904899. [El instrumento de imanes, y la primera dimensión del espacio latente, que suele ir con la intensidad y cuyo signo elige el entrenamiento al azar.]
Zheng, S. J., Xambó Sedó, A., Bryan-Kinns, N. (2025). Exploring gestural affordances in audio latent space navigation. Frontiers in Computer Science, 7, 1575202. DOI:10.3389/fcomp.2025.1575202. [El estudio de la tableta, con un RAVE entrenado con dos horas de guitarra y doce músicos analizados en sesiones de noventa minutos.]
Mudd, T., Holland, S., Mulholland, P. (2019). The Role of Nonlinear Dynamics in Musicians’ Interactions with Digital and Acoustic Musical Instruments. Computer Music Journal, 43(4), 25-40. DOI:10.1162/comj_a_00535. [Instrumentos de comportamiento no lineal que aun así se aprenden y se tocan de forma repetible.]
Shepardson, V., Stefánsdóttir, H. S., Magnusson, T. (2025). Evolving the Living Looper: Artistic Research, Online Learning, and Tentacle Pendula. NIME 2025, Canberra, pp. 255-260. DOI:10.5281/zenodo.15698851.
El mapeo
Fiebrink, R., Trueman, D., Cook, P. R. (2009). A Meta-Instrument for Interactive, On-the-fly Machine Learning. NIME 2009, Pittsburgh, pp. 280-285. DOI:10.5281/zenodo.1177513. [La presentación del Wekinator.]
Vigliensoni, G., Fiebrink, R. (2023). Steering latent audio models through interactive machine learning. ICCC 2023, Waterloo. ualresearchonline.arts.ac.uk/id/eprint/20199 [Con unas decenas de ejemplos basta para un mapeo que se pueda tocar.]
Construirse un modelo propio
Chemla-Romeu-Santos, A. (2024). Tutorial: Training RAVE models on custom data. IRCAM Forum, 21 de marzo de 2024. forum.ircam.fr/article/detail/training-rave-models-on-custom-data [Una hora de audio como mínimo, una tarjeta gráfica de 8 GB, de tres a cuatro días para la primera fase del entrenamiento y de cuatro días a tres semanas para la segunda, y la posibilidad de alquilar la máquina.]
Neutone (2022). Neural timbre transfer effects for Neutone. neutone.jp/blog/neural-timbre-transfer-effects-for-neutone [Las dos o tres horas de grabación.]
Bradic, A. (2025). The Art of Model Training with Neutone Morpho. Neutone, 25 de febrero de 2025. neutone.jp/blog/the-art-of-model-training-with-neutone-morpho [La hora variada frente a tres horas de una sola nota, el do sostenido que sale como re y la recomendación de grabar en una sola tonalidad.]
Herramientas citadas (estado a octubre de 2026)
RAVE, repositorio acids-ircam/RAVE en GitHub. [Licencia CC BY-NC 4.0. Última versión publicada, la 2.3.1, de diciembre de 2023, y actividad en la rama de desarrollo en marzo de 2026.]
nn~, repositorio acids-ircam/nn_tilde en GitHub. [Versión 1.6.0, del 22 de mayo de 2025.]
IRCAM Forum, New Release: RAVE VST plugin + RAVE models, 9 de abril de 2024.
Neutone FX y su catálogo de modelos, neutone.jp/fx.
FluCoMa, flucoma.org, y Data Knot, de Rodrigo Constanzo, paquete para Max, versión 1.0.3.
Wekinator, repositorio fiebrink1/wekinator en GitHub. [Última versión, de julio de 2016.]
Licencias y modelos con nombre
Neutone, preguntas frecuentes de Morpho, neutone.jp/morpho/faq. [Uso comercial del audio que produce, modelos privados de quien los entrena y permiso del titular de los derechos para entrenar con grabaciones ajenas.]
Neutone (2024). Introducing Neutone Morpho. neutone.jp/blog/introducing-neutone-morpho [El programa de modelos de artista con reparto de los ingresos de su venta.]
Catálogo de Neutone FX, fichas «RAVE.IILSopranoSax», del Intelligent Instruments Lab, entrenado con improvisaciones de saxo soprano de Franziska Schroeder, y «RAVE.086-jaap», entrenado con interpretaciones vocales de Jaap Blonk para el RAVE Model Challenge 2025 del IRCAM. Consultado en octubre de 2026.
IRCAM, página de modelos RAVE preentrenados, acids-ircam.github.io/rave_models_download. [El material de entrenamiento de cada modelo.]
La escena en España
Evans, N., Haki, B., Jordà, S. (2025). Repurposing a Rhythm Accompaniment System for Pipe Organ Performance. NIME 2025, Canberra, pp. 116-120. DOI:10.5281/zenodo.15698807. [Raül Refree con los órganos del Palau Güell, en el ciclo Organic.]
Actas de NIME de 2023 a 2026, nime.org. [Recuento propio de los trabajos firmados desde instituciones hispanohablantes.]
Los primeros sintetizadores
Pinch, T., Trocco, F. (2002). Analog Days: The Invention and Impact of the Moog Synthesizer. Harvard University Press.
Grabaciones enlazadas
MOTHERBIRD, de Jessica Shand, Manuel Cherep y Jack Armitage, con flauta y modelos RAVE de flauta y de pájaros. TENOR 2023, Boston. youtube.com/watch?v=kuxYIYgPrTs
Living Looper, ErkiTið 2023. youtube.com/watch?v=-KiQkexsml8