El equipo de investigación musical de Google, Magenta, publicó en 2020 un generador de audio neuronal basado en DDSP (procesado digital de señal diferenciable) capaz de sintetizar el sonido de un violín tras haber sido entrenado con trece minutos de música.
Trece minutos y cinco piezas de una partita de Bach tocadas por un solo violinista, tomadas de una biblioteca de dominio público: con eso bastó para que un modelo de IA produjese un sonido de violín sobre cualquier melodía que se le daba, con vibrato, ataque y la resonancia del cuerpo del instrumento.
¿Pero qué es lo que almacena en su interior ese modelo de IA? Si se tratase de fragmentos de las grabaciones con las que ha sido entrenado, estaríamos ante una copia evidente, identificable a través de herramientas (mejores o peores) que ya hemos descrito en artículos anteriores.
Pero no, ese modelo no almacena fragmentos musicales. ¿Qué tipo de dependencia estadística existe entonces entre esos trece minutos con los que fue entrenado y la capacidad resultante del modelo? ¿Y qué implicaciones tiene eso a nivel de atribución?
Para responder a esas preguntas hay que empezar por ponerles nombre a aparatos y procesos que quien produce música ya maneja todos los días.
Los números de un sintetizador
Un sintetizador clásico es una cadena de piezas conocida: un oscilador genera una serie de armónicos, un filtro recorta unos y deja pasar otros, una envolvente decide cómo crece y cae la intensidad en el tiempo, una reverberación añade el espacio. Cada pieza tiene ciertos parámetros, y esos parámetros son números que alguien decide: cuánto brilla el sonido, cuánto dura el ataque, qué armónicos pesan más.
Esos números tienen un significado. Subir el brillo es subir la energía de los armónicos altos, y quien mueve el mando sabe qué está tocando aunque no sepa la ecuación que hay por debajo. Esta rama de la ingeniería tiene nombre propio, DSP (Digital Signal Processing, procesado digital de señal, la matemática que hay debajo de un ecualizador, un compresor o una reverberación), y sus operaciones básicas están descritas y son públicas desde hace décadas.
El timbre, en estos términos, deja de ser una palabra vaga: define la distribución de energía entre armónicos y cómo esa distribución cambia a lo largo de una nota. Dos instrumentos que tocan un fa a la misma intensidad se distinguen porque reparten esa energía de manera distinta en el ataque, en el cuerpo y en la caída.
Por qué una red neuronal no puede usar un sintetizador
Un generador de audio neuronal de los que se han popularizado en los últimos años no tiene dentro nada de esa cadena de piezas que compone un sintetizador clásico.
Aprende a producir la forma de onda directamente, muestra a muestra, y en lugar de osciladores y filtros hay pesos ajustados durante el entrenamiento que no corresponden a ninguna magnitud audible. De ahí viene buena parte de la opacidad que ya describimos al hablar de la caja negra.
La pregunta obvia es por qué no juntar las dos cosas, poner una red neuronal a mover los mandos de un sintetizador que ya funciona y cuyos números tienen significado. La respuesta está en cómo aprende una red neuronal: por ensayo y error.
Una red neuronal produce un sonido, lo compara con el que buscaba y ajusta sus números para acercarse a él. Para hacer ese ajuste necesita saber qué mando mover y en qué sentido. Esa pista se calcula en la salida, donde se mide el error, y tiene que viajar hacia atrás hasta cada mando. Un módulo de procesado de señal corriente deja pasar el sonido hacia adelante, pero corta ese viaje de vuelta, por lo que la red neuronal se quedaría sin saber qué tendría que haber hecho de forma diferente.
Reescribir esos módulos para que ese viaje de vuelta sea posible es exactamente lo que da nombre a la técnica que aquel equipo de Google publicó en 2020 con el modelo de violín como demostración: DDSP (Differentiable Digital Signal Processing, procesado digital de señal diferenciable). En la palabra diferenciable está la condición que permite incluir un sintetizador clásico dentro de una red neuronal y entrenar el conjunto de una pieza.
Dos formas de entender un sonido
Con esa condición resuelta, el reparto de trabajo cambia.
En un generador de forma de onda la red neuronal tiene un doble trabajo que hacer: entender cómo funciona la física del sonido (que un tono armónico está hecho de sinusoides en relación de números enteros, que una sala añade una cola de reverb que decae), y capturar el estilo, el fraseo, el comportamiento expresivo que hace que una pieza sea reconocible como interpretación musical y no solo como un sonido correcto, que es lo único que en el fondo se le pide.
El paper original lo argumenta con un ejemplo. Cuatro segundos de una sinusoide, algo que un oscilador resuelve con dos números, frecuencia y amplitud, obligan a un modelo de forma de onda a representar decenas de miles de muestras individuales. Toda esa capacidad se gasta en reconstruir algo que ya se sabía describir.
En un sistema DDSP el aspecto de la física del sonido ya está incluido, escrito a mano, y la red solo aprende a manejarlo. No genera sonido, genera los parámetros del sintetizador y el sintetizador genera el sonido.
Esto supone una diferencia clave a nivel de tamaño. La versión reducida del modelo de violín que hizo el equipo de Magenta tiene 240.000 pesos, los números internos que se ajustan al entrenar. El sistema de referencia con el que lo compararon, un autocodificador basado en WaveNet, tiene 75 millones, unas trescientas veces más. Con 240.000 pesos el modelo cabe en cualquier ordenador y funciona en tiempo real, y esa es la razón técnica por la que estos sistemas se pueden tocar como se toca un instrumento, algo que desarrollaremos en la próxima entrega de esta serie.
¿Qué aprende un sistema DDSP en música?
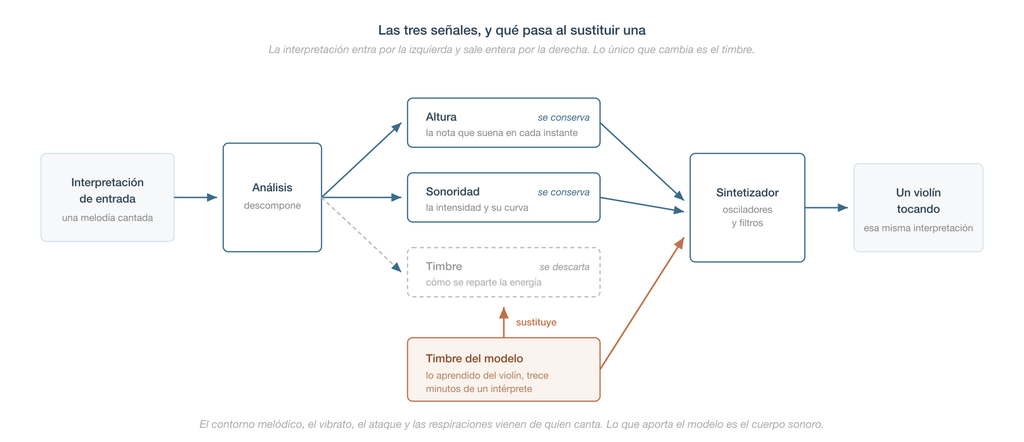
Un sistema DDSP descompone el audio de entrada en tres señales que cambian en el tiempo.
La primera es la f0 (frecuencia fundamental, la altura de la nota que suena en cada instante y que en el estudio se conoce como pitch), la segunda es la sonoridad y la tercera es el timbre (un resumen aprendido de cómo se reparte la energía entre los armónicos). Un decodificador convierte esas tres señales en los parámetros que necesita el sintetizador.
De las tres señales, la f0 o altura es la única que la red no calcula por su cuenta. Se la da un detector de tono entrenado aparte, porque deducirla por ensayo y error no da buenos resultados. Con las frecuencias, la pista que indica hacia dónde corregir deja de ser fiable, a veces apunta en sentido contrario, y el proceso acaba encallado en una altura equivocada de la que ya no sabe salir. Hay trabajo reciente sobre esto, pero los sistemas en uso siguen delegando esa parte.
Separar el sonido en esas tres señales es lo que permite entender qué está haciendo el sistema, algo que no ocurre con todos los modelos de IA generativa. Pero «entender» puede querer decir varias cosas distintas, y no están resueltas al mismo nivel.
Lo que sí se entiende es qué produce el sistema: la señal sale de unos osciladores y unos filtros cuyo comportamiento está descrito. Entender por qué la red eligió ese reparto de armónicos para una ejecución concreta ya es más difícil, porque el modelo que emite los parámetros sigue siendo una red, y que su salida sea legible no hace legible su lógica interna. Hay una investigación en marcha para dar estructura reconocible a esos controles, y para medir cuánta precisión cuesta imponerla.
Queda entender de quién aprendió el sistema ese comportamiento. Esa pregunta sigue sin respuesta, porque poder mirar los mandos no dice quién le enseñó a moverlos.
El timbre como espacio tocable
Con la altura, la sonoridad y el timbre por separado, transferir un timbre se vuelve una operación casi mecánica, sustituir una de las tres señales y volver a sintetizar.
Se canta una melodía. De esa interpretación el sistema toma la altura y la sonoridad. El timbre lo pone el modelo, que es donde se guardó lo aprendido del violín. Con esas tres señales el sintetizador produce el resultado, un violín tocando lo que se acaba de cantar. El contorno melódico, el vibrato, la manera de atacar cada nota, las respiraciones que marcan el fraseo, todo eso viene de la ejecución de entrada y se conserva en la salida. Lo que cambia es el cuerpo sonoro.
Esta técnica encaja así con la tesis que abrió esta serie. El artículo anterior distinguía la IA que interviene en un punto del proceso y devuelve el control de la que produce una obra completa a partir de una indicación escasa, y proponía tres criterios para situar cada herramienta. Un sistema de transferencia de timbre es generativo por dentro, produce sonido nuevo que no existía, y sin embargo funciona como instrumento, porque toda la información musical la sigue aportando una persona y lo único que la máquina decide es el color.
Qué permite auditar DDSP y qué no revela
“Auditar un modelo” es una frase con muchas interpretaciones, y detrás pueden esconderse preguntas bastante distintas.
Dos de ellas no dependen de cómo esté construido el modelo.
Saber qué archivos entraron en el entrenamiento exige que alguien lo apuntara, un inventario del material, las licencias, las credenciales de procedencia.
Y saber si un archivo salió de un sistema concreto exige que ese sistema marcara sus salidas, con marcas de agua o credenciales. Ninguna de las dos se responde mirando dentro, se responden con registros hechos a tiempo, y da igual que el modelo sea DDSP o un generador de forma de onda.
Qué aprendió el sistema para producir un sonido es otra pregunta, y ahí DDSP saca ventaja por lo dicho antes: sus parámetros son inspeccionables. En un generador de forma de onda no hay parámetros que mirar.
Y queda la pregunta que de verdad se hace un intérprete, si su interpretación está ahí dentro. Suele hacérsela cuando no hay inventario, o cuando no se fía del que le enseñan, así que la documentación no le sirve, tiene que interrogar al modelo. En los grandes generadores hay investigación activa, técnicas que estiman qué ejemplos de entrenamiento contribuyeron a una salida, o que intentan decidir si un material estuvo en el corpus. Sobre un sistema de transferencia de timbre no se ha probado ninguna.
C2PA, la especificación de credenciales que ya describimos, sirve para llevar esos registros, y su versión actual cubre también los datos y los modelos usados al entrenar. Pero declara la procedencia mientras se construye el sistema, no la descubre después.
Con la huella acústica pasa algo parecido: sirve antes del entrenamiento para inventariar y comparar el material de un corpus. Después sirve poco, porque busca fragmentos reconocibles y aquí no los hay. Un sintetizador produce una onda nueva con sus osciladores y sus filtros, y en esa onda no tiene por qué aparecer ningún tramo que se parezca a un fonograma.
Lo aprendido, en un sistema así, no está guardado como fragmentos que se puedan recuperar, está comprimido en una función que decide cómo se comporta un sintetizador. Afirmar que el modelo no contiene nada de quien tocó sería decir más de lo que se ha comprobado, nadie ha demostrado que uno de estos sistemas no pueda memorizar rasgos concretos de sus ejemplos. Lo que sí se puede afirmar es que buscar copias no basta.
¿De dónde sale el timbre?
El violinista de aquellos trece minutos que utilizó Magenta para entrenar a su generador de audio neuronal se llama John Garner. Aparece en el apéndice del paper del proyecto, con la obra y la fuente, y los investigadores que lo escribieron eligieron a propósito un solo intérprete y una sala consistente para que el modelo se concentrase en el comportamiento del instrumento.
Trece minutos es poco: modelar cómo suena alguien cuesta mucho menos material del que se suele suponer cuando se habla de grandes corpus de entrenamiento. Seis años después del proyecto de Google, la situación no ha mejorado en favor de quien interpreta, solo ha cambiado de forma.
Los modelos específicos y restringidos siguen necesitando muy poco material. Neural Analog, un servicio comercial que hoy los entrena por encargo, sigue pidiendo entre diez y quince minutos de audio limpio de un instrumento, según su propia documentación. Los modelos que generan la forma de onda piden bastante más, el IRCAM pone el mínimo en una hora para entrenar uno de los suyos, y su propia documentación recomienda tres.
El cambio de fondo no está ahí, está en la conversión de voz cantada, la técnica que traslada la identidad vocal de una persona a la interpretación de otra. Ahí el material de entrenamiento ya no sale de la persona que se quiere reproducir. Sale de decenas o centenares de horas de muchas otras, con las que se construye un modelo general de cómo funcionan las voces. Con ese modelo hecho, para reproducir una voz nueva basta una referencia breve en el momento de usarlo. Esa persona no ha estado en el entrenamiento. El Singing Voice Conversion Challenge, un evento científico en el que se comparan distintos sistemas de conversión de voz cantada usando una base de datos común, planteaba en 2025 los dos escenarios a la vez: unas cuatro horas y media de la voz objetivo si el sistema se especializa en ella, y ninguna si el modelo base ya sabe representar identidades vocales.
El consentimiento, en este escenario, tiene que pedirse dos veces. Hay que pedirle permiso a la persona cuya voz queremos reproducir, pero también a las personas cuyas voces nos servirán para construir el modelo general. Y de ese segundo consentimiento no se está hablando todavía.
La primera petición de consentimiento, en cambio, sí se hace, y con bastante detalle, aunque de momento al otro lado del Atlántico. El acuerdo que SAG-AFTRA firmó en 2024 con las discográficas estadounidenses, un convenio colectivo sin efecto fuera de allí, trata la réplica digital de una voz como un uso que hay que autorizar y pagar. Exige consentimiento expreso, en un documento aparte y con una descripción específica de para qué, y prohíbe autorizarlo en bloque. Si esa réplica acaba en una grabación publicada, a quien cantó en la sesión sin participar en las regalías le corresponde un pago mínimo equivalente a tres pistas por proyecto. Y convocarle a una sesión para construir la réplica obliga a avisar con 48 horas y a pagarle esa sesión como trabajo.
Este conjunto de reglas no tiene fuerza legal ni contractual fuera de Estados Unidos, pero nos sirve para visualizar un escenario en el que se negocia con cifras y plazos claros, no solo con principios.
La preocupación a nivel europeo es evidente. En el informe conjunto que FIM, FIA, EFJ y UNI Europa publicaron en 2026, todas las organizaciones musicales consultadas se declararon preocupadas por la propiedad intelectual, un 92% por la clonación de voz y las actuaciones sintéticas y un 85% por la remuneración y las condiciones de trabajo.
Ahora bien, todo eso hace referencia a la voz, la imagen, la réplica digital de una persona. Del timbre de un instrumentista modelado como comportamiento de un sintetizador no se está hablando, y no consta ninguna posición de una entidad de gestión colectiva que lo plantee. Es un caso que no encaja en los marcos disponibles, porque no hay fonograma reproducido al que agarrarse.
Hay modelos construidos con autorización, en todo caso, y demuestran que esto se puede hacer bien. El más documentado es Noche Buena y Navidad, la versión en español de Rockin’ Around the Christmas Tree que Universal publicó en octubre de 2024. Leyla Hoyle cantó la letra en español reproduciendo la altura, las respiraciones y el fraseo de Brenda Lee, y un modelo transfirió sobre esa ejecución la identidad vocal de Lee, que aprobó el proyecto y escuchó y aprobó el resultado antes de publicarlo. En una misma toma conviven ahí dos aportaciones distintas, la de quien ejecuta y la de quien presta el timbre.
Hay más casos, aunque todo lo que se sabe de ellos sale de las propias empresas. Voice-Swap, que ya apareció en nuestro artículo sobre la caja negra por entrenar con improvisaciones en lugar de con canciones enteras, dice que contrata directamente con artistas y titulares y que cada uso del modelo genera ingresos para quien puso la voz.
Kits AI afirma algo parecido: la persona que canta entrena y verifica un modelo con su propia voz y cobra cuando alguien descarga audio hecho con ella.
ACE Studio declara que sus voces vienen de cantantes con licencia y que reparte los derechos con ellos, y es la que más cerca queda del instrumentista, porque sus modelos de instrumentos salen de sesiones grabadas con una orquesta a la que acredita. Aunque de un reparto con quienes tocaron en esas sesiones no dice nada.
Ninguna publica el registro que permitiría comprobarlo, ni qué sesiones se usaron, ni cuántos minutos aportó cada persona, ni el porcentaje que recibe. Han hecho pública la regla, no el registro.
Lo que cuesta la restricción
Lo que hace auditable a este tipo de sistemas es también lo que limita sus capacidades. Como ya señalamos al comparar modelos regresivos y generativos, potencia y explicabilidad están reñidas.
Un trabajo de 2025 enfrentó cuatro sistemas de conversión de voz cantada entrenados con el mismo material (cincuenta horas) y evaluados sobre cuatro personas que no aparecían en el entrenamiento. El sistema basado en síntesis diferenciable quedó último en naturalidad y en parecido con la voz de destino, con un dos sobre cinco de un panel de oyentes con formación musical, frente a valores entre tres y cuatro de los demás. El resultado no condena la técnica, porque un sistema basado en síntesis diferenciable mejor construido podría tener un mejor rendimiento. Lo que sí deja claro es que un modelo no suena mejor por dejarse entender.
Otro trabajo posterior combinó los dos enfoques (diferenciable/paramétrico y generativo) en un mismo sistema, y al quitarle la parte diferenciable mejoraron la inteligibilidad y la precisión de la altura, pero empeoró el parecido de timbre. Es decir, tener ese componente paramétrico no hace que el sistema sea mejor ni peor en conjunto: lo que hace es cambiar en qué falla. Cuando está presente, cuida mejor el timbre pero limita la inteligibilidad y el tono. Cuando se elimina, el sistema gana soltura para reconstruir el resto del sonido pero pierde parecido con la voz original.
Y ser eficiente tampoco implica sonar mejor. Un modelo de síntesis vocal construido sobre estos principios entrena con un tercio de la memoria y calcula diez veces más rápido, y aun así obtiene peores medidas de calidad que el sistema con el que se compara.
La polifonía sigue fuera del alcance. Ninguna arquitectura de este tipo resuelve la transferencia de timbre sobre mezclas densas, y lo que avanza ahí son modelos de difusión, mucho menos restringidos y mucho menos auditables. Para cambiar un elemento dentro de una mezcla conservando el resto, la potencia pesa más que la transparencia.
Herramientas DDSP ¿Hacia dónde vamos?
Hay menos herramientas de las que hacen pensar los ejemplos y aplicaciones que se han publicado. La biblioteca original del generador de audio neuronal de Google sigue siendo pública, su página de demostración sigue en pie, y Neural Analog entrena modelos por encargo, pero el plugin que llevó esta técnica a los estudios está archivado desde octubre de 2024.
Lo que hoy se vende bajo el nombre de “transferencia de timbre” suele ser, en realidad, otra familia de sistemas: autocodificadores que generan la forma de onda directamente. De puertas para afuera hacen algo parecido y suenan de forma similar, pero por dentro son tan opacos como cualquier otro generador, sin la transparencia que caracteriza a los sistemas DDSP.
¿Qué hay que hacer entonces para no dejarse guiar por el nombre comercial de cualquier herramienta que se presente así? Hay que mirar qué produce literalmente su última capa. Si produce amplitudes de armónicos y ajustes de filtros, es DDSP, y vale todo lo dicho aquí sobre su auditabilidad. Si produce directamente la forma de onda, la auditoría vuelve al punto de partida, por más que la interfaz prometa lo mismo.
La técnica DDSP no ha ganado la carrera hacia el sintetizador universal, y probablemente nunca fue esa su función. Lo que ha dejado tras de sí es una manera de construir sistemas musicales donde la red gobierna un instrumento en vez de sustituirlo, y esa idea sigue viva en la investigación y en algunos proyectos artísticos.
Su valor para quien interpreta no está en el sonido, ahí tiene rivales mejores, está en que es de los pocos sitios donde podemos ver cómo se genera el sonido. Esa transparencia, eso sí, se detiene al llegar a una pregunta clave: quién aportó la interpretación original que hizo posible el modelo, y si dio su consentimiento. Cerrar ese hueco es trabajo pendiente, y no solo de quien construye los sistemas.
En la próxima entrega de esta serie, ahondaremos en cómo se toca en tiempo real este tipo de modelos.
Fuentes
El modelo de violín y la técnica
Engel, J., Hantrakul, L., Gu, C., Roberts, A. (2020). DDSP: Differentiable Digital Signal Processing. ICLR 2020. arXiv:2001.04643. [Los trece minutos de violín solo de John Garner, cinco piezas de la Partita nº 1 BWV 1002 tomadas de MusOpen, están en el apéndice. Los recuentos de parámetros, 0,24 M el modelo reducido frente a 75 M del autocodificador WaveNet, en la tabla B.6. El argumento de la sinusoide de cuatro segundos, en el cuerpo.]
Hayes, B., Shier, J., Fazekas, G., McPherson, A., Saitis, C. (2024). A review of differentiable digital signal processing for music and speech synthesis. Frontiers in Signal Processing, vol. 3. DOI:10.3389/frsip.2023.1284100. [Revisión de conjunto y de los límites conocidos, incluida la dependencia de detectores de tono externos.]
Hayes, B., Saitis, C., Fazekas, G. (2023). Sinusoidal Frequency Estimation by Gradient Descent. ICASSP 2023. arXiv:2210.14476. [Por qué la altura no se aprende bien por corrección progresiva.]
Comparaciones de calidad
Chen et al. (2025). DAFMSVC: One-Shot Singing Voice Conversion with Dual Attention Mechanism and Flow Matching. Interspeech 2025. arXiv:2508.05978. [La comparación de cuatro sistemas con el mismo corpus de cincuenta horas y las valoraciones del panel de escucha.]
Bai et al. (2026). HQ-SVC: Towards High-Quality Zero-Shot Singing Voice Conversion in Low-Resource Scenarios. AAAI 2026. arXiv:2511.08496. [El experimento de quitar la parte diferenciable dentro del mismo sistema.]
Yu, C.-Y., Fazekas, G. (2023). Singing Voice Synthesis Using Differentiable LPC and Glottal-Flow-Inspired Wavetables. ISMIR 2023. arXiv:2306.17252. [Menos memoria y más velocidad sin mejor calidad.]
Demerlé et al. (2024). Combining Audio Control and Style Transfer Using Latent Diffusion. arXiv:2408.00196, y Li et al. (2026), Polyphonia, arXiv:2605.10203. [Los avances en polifonía, por la vía de la difusión.]
Auditoría y procedencia
Choi et al. (2025). Large-Scale Training Data Attribution for Music Generative Models via Unlearning. arXiv:2506.18312.
Proboszcz et al. (2025). Membership and Dataset Inference Attacks on Large Audio Generative Models. arXiv:2512.09654.
C2PA, Guidance for Artificial Intelligence and Machine Learning (consultada ago 2026). [Contempla credenciales para los conjuntos de entrenamiento, el software, los modelos entrenados y el contenido de salida. Todo ello exige aserciones hechas durante la construcción del sistema.]
Cuánto material hace falta
Singing Voice Conversion Challenge 2025. [Las cuatro horas y media de la voz objetivo, y el escenario sin datos de entrenamiento.]
Neural Analog, documentación del servicio de entrenamiento (nov 2025). [Los diez a quince minutos por instrumento.]
IRCAM, tutorial de entrenamiento de RAVE con datos propios. [El mínimo de una hora.]
Consentimiento y marcos
SAG-AFTRA (2024). Sound Recordings Code y su apéndice sobre inteligencia artificial. [Consentimiento expreso, prohibición del consentimiento en bloque, mínimo de tres pistas por proyecto y las cuarenta y ocho horas de aviso.]
FIM, FIA, EFJ y UNI Europa (2026). AI and Work in the Media, Arts & Entertainment Sector, informe sectorial FIM.
Universal Music Group y SoundLabs (oct 2024), comunicados sobre Noche Buena y Navidad.
Voice-Swap, Kits AI y ACE Studio, documentación pública de cada empresa. [De ACE Studio está documentado que las voces proceden de cantantes con licencia y que hay reparto con ellos, y que las secciones de cuerda se grabaron con la Budapest Art Orchestra. No consta que el reparto alcance a los instrumentistas, comprobado ago 2026.]
Herramientas citadas
Magenta, repositorios ddsp (público) y ddsp-vst (archivado el 9 de octubre de 2024).